


前言
本文件按照 GB/T 1.1—2020《标准化工作导则 第1部分:标准化文件的结构和起草规则》的规定起草。
本文件是 GB/T(Z)45288《人工智能 大模型》的第4部分。GB/T(Z)45288 已经发布了以下部分:
第1部分:通用要求;
第2部分:评测指标与方法;
第3部分:服务能力成熟度评估;
第4部分:计算机视觉大模型;
第5部分:多模态大模型;
第7部分:语音大模型。
请注意本文件的某些内容可能涉及专利。本文件的发布机构不承担识别专利的责任。
本文件由全国信息技术标准化技术委员会(SAC/TC 28)提出并归口。
本文件起草单位:中国电子技术标准化研究院、华为云计算技术有限公司、浙江大学、北京智源人工智能研究院、浦江国家实验室、北京航空航天大学、科大讯飞股份有限公司、蚂蚁科技集团股份有限公司、北京智谱华章科技股份有限公司、上海商汤智能科技有限公司、阿里云计算有限公司、北京百度网讯科技有限公司、清华大学、启元实验室、北京交通大学、北京邮电大学、中国移动通信集团有限公司研究院、中国电信股份有限公司北京研究院、中国电力科学研究院有限公司、中国电信股份有限公司上海研究院、国能数智科技开发(北京)有限公司、南方电网数字电网集团有限公司、海信视像科技股份有限公司、杭州海康威视数字技术股份有限公司、杭州电子科技大学、浙江大华技术股份有限公司、中国移动通信集团有限公司、上海计算机软件技术开发中心、中电信数智科技有限公司、深圳思谋信息科技有限公司、中国工商银行股份有限公司、哈尔滨工业大学、北京市公安局人工智能安全研究中心、浙江理工大学、国投智能信息科技股份有限公司、同方知网数字科技有限公司、北京格灵深瞳信息技术股份有限公司、浪潮通信信息系统有限公司、青岛港国际股份有限公司、中国科学院软件研究所、中国科学院沈阳自动化研究所、中国南方电网有限责任公司超高压输电公司、中关村智联软件服务业质量创新联盟、安徽大学、中兴通讯股份有限公司、中央民族大学、中移(杭州)信息技术有限公司、中移(苏州)软件技术有限公司、中移雄安信息通信科技有限公司、中国航天科技体系与创新研究院。
本文件主要起草人:范科峰、郑子木、郑若琳、吴飞、刘颖、蒋慧、徐洋、刘祥龙、李建欣、陶建华、王志栋、鲍薇、王浩然、况琨、董建、殷兵、孙曦、冯涛、吴庚、吴涛、于佃海、张圣宇、王永威、杨熙、石羡、刘艾杉、王嘉凯、汪群博、左兴权、杨乐、曹晓琦、刘伟东、王峰、陈晰、宋光磊、阎岩、韩韬、杨旭、李晋伟、张学聪、李晨、黄现翠、李亚玲、卢顺、高东辉、焦若丹、刘卫卫、梁寿愚、朱春波、任文奇、李孟择、付建海、曹汐、陈敏刚、陈利明、杨晓诚、李哲欣、李海峰、郭影起、佟威、阙锦龙、李达、冯子勇、梁秉豪、吴宇震、郭乙运、孟令中、王鑫、王宁、吕飞燕、范存航、赵孝武、赵小兵、谢小燕、李旭东、郑庆国。
引言
大模型已成为人工智能发展的重要技术手段,在引领产业变革方面发挥着重要作用,国内外各企业和研究机构相继开发百余种大模型产品和评测榜单,导致用户难以有效评价业内产品的技术水平和服务能力。GB/T(Z)45288《人工智能 大模型》旨在规定通用大模型的技术要求、评测指标和服务能力,拟由九个部分构成。
—— 第1部分:通用要求。目的在于确立大模型的参考架构,规定通用技术要求。
—— 第2部分:评测指标与方法。目的在于确立大模型的评测指标,描述评测方法。
—— 第3部分:服务能力成熟度评估。目的在于给出大模型服务能力成熟度等级及评估方法。
第4部分:计算机视觉大模型。目的在于确立计算机视觉大模型的参考框架,规定技术要求,描述测试方法。
第5部分:多模态大模型。目的在于规定多模态大模型的参考架构,规定技术要求。
第6部分:代码大模型。目的在于定义代码大模型的概念和功能,规定技术要求和测试方法。
第7部分:语音大模型。目的在于定义语音大模型的概念和功能,规定技术要求和测试方法。
第8部分:时间序列大模型。目的在于定义时间序列大模型的概念和功能,规定技术要求和测试方法。
第9部分:图大模型。目的在于定义图大模型的概念和功能,规定技术要求和测试方法。
1 范围
本文件确立了计算机视觉大模型的参考框架,规定了相关技术要求,描述了对应的测试指标和方法。本文件适用于计算机视觉大模型的设计和测试。
2 规范性引用文件
下列文件中的内容通过文中的规范性引用而构成本文件必不可少的条款。其中,注日期的引用文件,仅该日期对应的版本适用于本文件;不注日期的引用文件,其最新版本(包括所有的修改单)适用于本文件。
GB/T 41864—2022 信息技术 计算机视觉 术语
GB/T 41867—2022 信息技术 人工智能 术语
GB/T 45087—2024 人工智能 服务器系统性能测试方法
GB/T 45288.1—2025 人工智能 大模型 第1部分:通用要求
GB/T 45288.2—2025 人工智能 大模型 第2部分:评测指标与方法
GB/T 45288.5—2026 人工智能 大模型 第5部分:多模态大模型
3 术语和定义
GB/T 41864—2022、GB/T 41867—2022、GB/T 45288.1—2025 界定的以及下列术语和定义适用于本文件。
3.1 标签 label
分配到样本的目标变量。
[来源:ISO/IEC 22989:2022,3.2.10]
3.2 异常 anomaly
偏离预期的分布。
注 1:异常通常体现为离群数据。
注 2:异常类型包括小区域异常、大范围区域异常、序列异常。其中序列异常指视频中时间维度的连续异常。
3.3 计算机视觉大模型 computer vision large⁃scale model
以视觉数据作为一种输入,用于实现视觉任务的大模型。
注 1:视觉数据包含图像(含 3D 图像、点云、红外、高光谱数据等)或视频(含 3D 视频)。
注 2:按技术机制与应用范畴分为通用视觉大模型、多模态视觉大模型和专用视觉大模型。
注 3:计算机视觉大模型简称视觉大模型。
3.4 通用视觉大模型 general vision large⁃scale model
以视觉数据为必要输入,通过多任务表征映射过程,输出结构化视觉处理结果的大模型。
注 1:模型输入以视觉数据为主,辅以点、框、标签或文本输入作为引导或参照条件。
注 2:模型输出的结构化视觉处理结果具体呈现形式由应用决定,如目标定位坐标、像素级分割掩码、物理深度等数值张量,以及目标分类、属性判定、特征向量等语义张量等。
3.5 多模态视觉大模型 multi⁃modal vision large⁃scale model
以视觉数据、文本数据等为输入,通过生成式过程,输出多模态处理结果的大模型。
注 1:多模态大模型具体技术要求适用 GB/T 45288.5—2026 相关约定,视觉相关补充约定参考附录 A。
注 2:模型输入为文本数据、视觉数据或其组合,其中视觉数据为可选输入。
注 3:模型输出中的多模态处理结果具体呈现形式由应用决定,如文本、图像、视频、结构化信息、空间坐标等。
3.6 专用视觉模型 specific vision model
以专用视觉数据为必要输入,通过领域专用知识适配,面向特定应用场景完成视觉任务的模型。
注 1:模型适用于预设且固定、不根据要求变化的视觉任务,参考附录 B。
注 2:模型制备方式包括架构定制构建、多模型组合、视觉大模型蒸馏或微调,或其他领域适配方法,部分不保留大模型架构。其中,保留视觉大模型架构并通过领域适配形成的专用视觉模型称为专用视觉大模型。
3.7 [计算机视觉]任务 [computer vision] task
为实现特定目标所需的活动。
注:在人工智能领域,任务由目标及模型组成,其中目标由输入定义域或输出值域表征。
4 缩略语
下列缩略语适用于本文件。
API:应用编程接口(Application Programming Interface)
SDK:软件开发工具包(Software Development Kit)
VSLAM:视觉同步定位与建图(Visual Simultaneous Localization and Mapping)
3D:三维(3 Dimension)
5 参考框架
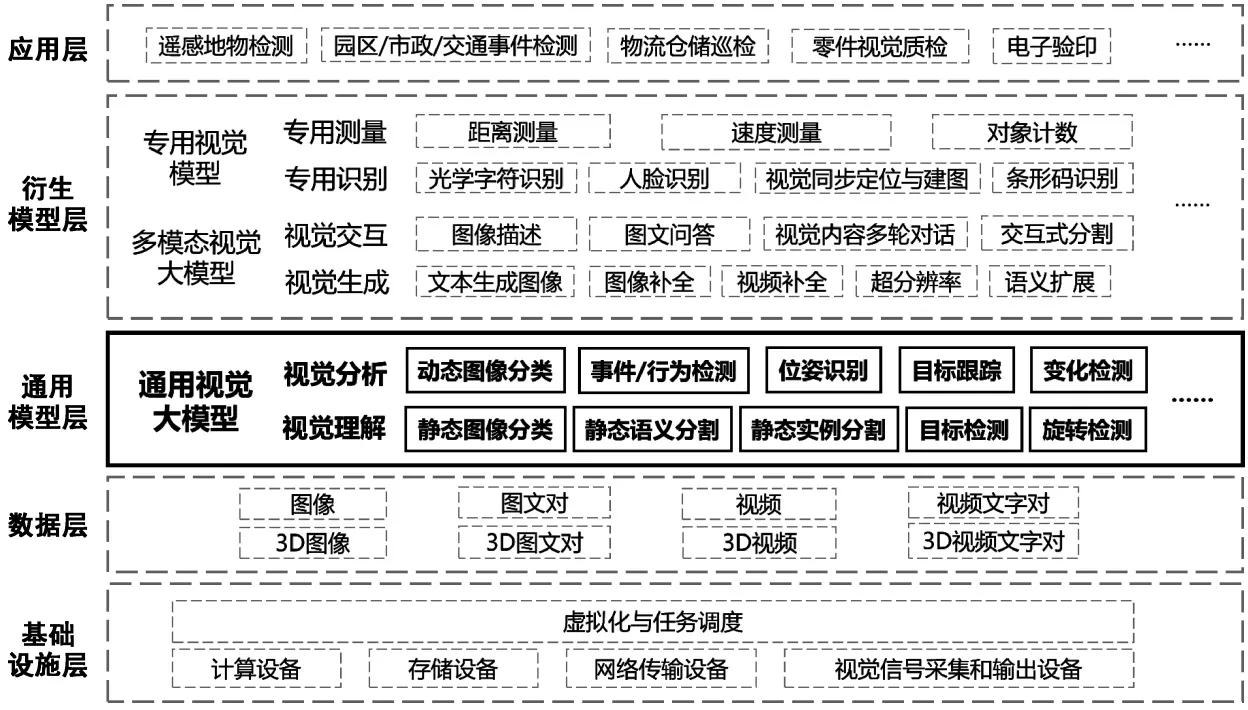
计算机视觉大模型系统的参考框架如图 1,包括基础设施层、数据层、通用模型层、衍生模型层、应用层。
a) 基础设施层为各层级提供计算资源调度、存储服务、网络传输支持,保障数据流转与模型运行效率。
b) 数据层对基础设施层获取的原始数据进行清洗、格式转换、标注等预处理,输出图像、视频、图文对等标准化数据至模型层。
c) 通用模型层或衍生模型层对输入数据进行处理,向应用层提供视觉处理结果。
1) 通用模型层:面向通用视觉大模型,以视觉数据为主要输入,大模型将视觉理解、视觉分析等多任务联合建模,主要用于执行高确定性需求的通用任务。
2) 衍生模型层:通用模型层是衍生模型层的制备来源之一。衍生模型层基于多模态视觉大模型或专用视觉模型,提供视觉处理结果。
d) 应用层结合具体场景需求,向用户提供直接可用的服务。
本文件对于参考框架中虚框所示的基础设施层、数据层、衍生模型层和应用层不作规定。多模态视觉大模型、专用视觉模型等衍生模型可参考附录 A、附录 B。测评指标计算方法按附录 C 的规定。
6 技术要求
6.1 视觉理解
6.1.1 静态图像分类
用于图像分类任务的视觉大模型:
a) 应输出图像或图像中指定物体所属的预先定义的类别;
b) 宜提供开集分类能力,如通过文本标签为未预设覆盖的类别进行分类。
6.1.2 静态语义分割
用于语义分割任务的视觉大模型:
a) 应检测并输出像素对应类别,不同类别用不同颜色标示;
b) 宜定义图形绘制的类别;
c) 宜自定义待分割实例描述,如使用自然语言;
d) 宜提供开集分割能力,如通过自然语言为未预设覆盖的类别进行分割的能力。
6.1.3 静态实例分割
用于实例分割任务的视觉大模型:
a) 应检测并输出实例及其对应类别,不同实例用不同颜色标示;
b) 宜自定义待分割实例描述,如使用自然语言;
c) 宜定义图形绘制的类别。
6.1.4 目标检测
用于目标检测任务的视觉大模型:
a) 应在图像或视频中标定预设的待检目标,输出边界框;
注 1:边界框为无旋转角度的标准矩形框,至少包含目标类别、位置,可包含置信度,下同。
b) 宜在视频中标定预设的待检目标,输出含有物体的帧图像及边界框;
c) 宜检出小目标;
注 2:“小目标”的具体界限按场景要求确定,如 32 px×32 px。
d) 宜提供多目标检测;
e) 宜提供开集检测的能力,如使用自然语言或标签描述提供为未预设覆盖的目标进行检测。
6.1.5 旋转检测
用于旋转检测任务的视觉大模型:
a) 应在图像中标定预设的待检物体,输出旋转边界框;
b) 宜在视频中标定预设的待检物体,输出含有物体的帧及旋转边界框;
c) 宜检出小物体;
注:“小物体”的具体界限按场景需求确定,如 32 px×32 px。
d) 宜完成多物体检测。
6.1.6 异常检测
用于异常检测任务的视觉大模型:
a) 应检出含有异常的图像;
b) 应标记图像或视频中的异常区域,如边界框、像素级掩码或热力图;
c) 可检出异常类型;
d) 宜检出含有异常的视频帧;
e) 宜检出小区域异常;
注:“小区域”的具体界限按场景需求确定,如 32 px×32 px。
f) 宜检出图像或视频中包含的多个异常。
6.1.7 实例识别
用于实例识别任务的视觉大模型:
a) 应从图像或视频中识别特定实例的位置,或者判断图像或视频是否含有特定实例;
b) 宜按自然语言描述识别实例。
注:实例指具有唯一标识的个体,如特定物体、特定人员。
6.2 视觉分析
6.2.1 动态图像分类
用于视频分类任务的视觉大模型,符合以下要求:
a) 应输出视频所属的预先定义的类别;
b) 应提供长视频(时长不小于 60 s)分类能力。
6.2.2 事件/行为检测
用于事件/行为检测任务的视觉大模型:
a) 应从视频中检测预先定义的事件或动作;
b) 宜检测人员或物体进入或离开特定区域;
c) 宜检测视频,输出特定事件发生的时间及动作。
6.2.3 位姿识别
用于位姿识别任务的视觉大模型:
a) 应检出人员或物体关键点(如骨架)并输出姿态描述信息(如人头部、手、足等的位置);
b) 宜对图像或视频帧中的多个物体或人员输出姿态估计描述。
6.2.4 目标跟踪
用于目标跟踪任务的视觉大模型:
a) 应提供在帧率不小于 25 帧/秒的视频中跟踪的能力;
b) 应至少在关键帧中标出待跟踪目标,如使用边界框;
c) 宜支持同时跟踪不少于两个目标,并将不同目标作区别标识(如不同颜色边界框);
d) 目标在一段视频中被完全或部分遮挡时,宜支持延续跟踪,及时调整标识位置;
e) 当目标消失在视频中后重新出现时,宜支持再次跟踪目标;
f) 宜支持使用自然语言指定待跟踪的目标。
6.2.5 变化检测
用于变化检测任务的视觉大模型:
a) 应检出图像或视频中特定物体的变化,如实例、位置、纹理或形状等;
b) 宜标记图像或视频中的变化区域;
c) 宜检出图像或视频中 2 个或以上物体的变化。
7 测评方法
7.1 通则
视觉大模型相关测评任务、测评要素和测评维度应按 GB/T 45288.2—2025 第 5 章评测框架,并实施测试。具体地,视觉大模型的测试,符合以下要求:
a) 被测对象应是视觉大模型,其中包含测试任务所需配备的编解码、前后处理、存储、自然语言或符号提示词处理、工作流编排及执行等必要组件;
b) 被测对象应以 API 远程、SDK 本地或图形用户界面(如网页)驱动;
c) 测试对象应支持使用测试集并向被测对象发送调用请求、接收输出结果并按测试项的要求统计、计算准确性指标值、响应时延或吞吐量;
d) 被测对象不应参与任何测试样本正误的判断,也不应计算指标值;
e) 测试对象与测试工具宜分离部署;
f) 测试样本的发送应按 GB/T 45087—2024 中 7.4.2 的连续(单一)到达模式执行;
g) 为每项测试配备测试集,单项测试数据集样本数应不小于 2 000;
h) 单项测试时,应从单项测试数据集中随机抽样不少于 200 个样本;
i) 多个视觉大模型同批测试时,应使用相同的测试集、抽样方法、指标和主客观测试方法;
j) 应从 GB/T 45288.2—2025 中 6.5 选择客观、主观或基于判别模型的方案实施测试。
7.2 测评流程
视觉大模型效果的测评通常分为客观测评和主观测评。其中,客观测评依据 GB/T 45288.2— 2025、本文件 7.1 及附录 C 指标进行评价,主观测评应由测评组(见 7.4)按以下流程实施。
a) 为测评组中的每位成员随机等比例分配测试样本子集,成员针对单个指标独立完成测评。
b) 对每个测评样本,将输入、输出与参考值(如存在)组成元组。根据任务不同,测评样本可以是视觉数据、文本数据及其组合。
c) 开始测评。
d) 展示首个测评样本元组,展示时长为 p, ,单位为秒(s)。
e) 测评样本元组的展示时长 p 为元组内全部测试样本展示时长之和。其中,视频测试样本的展示时长为视频时长。图像和自然语言测试样本的展示时长可按平均阅读速度确定,如图像15 张/min、文本 300 字(词)/min,也可通过在测试前随机抽取多个测试样本实验确定平均阅读速度。
f) 测评人员在每个元组展示结束后,在评分周期内给出评分(5 分制,每级的含义由指标定义),评分周期时长 g[ 单位为秒(s)]。
g) 测评后,撤去已评分元组,经过时间间隔 d[单位为秒(s)],展示下一个测评样本元组,按 e)和f)的规定评分。
h) 在所有测评样本测评完毕后,按指标定义计算总分。若指标未定义时,按附录 C 中 C.2.1 的规定计算总分。
i) 若在测评样本元组的展示周期及评分周期内未完成测评,则在测评的最后补充展示、评分。
j) 若测评人员对测评样本子集整体的测评率不足 r(用百分数表示),则该测评人员的测评结果不计入总分,从候补组抽取人员对该测评样本子集评分。
k) 按测评需要,采用单轮、多轮同子集等方法,按以下规则计分:
1) 单轮:对特定样本元组给出的分数即为该测评人员的最终给分;
2) 多轮同子集:对特定样本元组给出的分数为多轮同样本得分的平均。
7.3 测评数据
视觉大模型效果的测评集,基于样本多样性及开集测评考虑,宜符合如下要求:
a) 两种或以上视角,如正、背、顶、底、左侧、右侧或其他角度;
b) 两种或以上大小,如拍摄距离的变化导致同一物体大小改变;
c) 两种或以上光照,如亮度、色饱和度、色温;
d) 两种或以上分辨率;
e) 存在物体形状、颜色或位置变化,如不同状态、颜色或位置下的气球;
f) 存在干扰,如同一前景物体下的不同背景干扰、纹理变化干扰、噪声干扰;
g) 存在遮挡,如人为遮挡或自然遮挡。
7.4 测评组
视觉大模型效果的测评,主观方法由测评组实施,测评组的组成与测评人员符合以下要求。
a) 测评组应由 n 人组成 (n ≥5 ,男女比例均衡),随机抽取人员分配到实施组和候补组,分别包含 n1 人和 n2 人 (n=n1+n2,n1≥3,n2≥2) 。
b) 测试样本的子集数量应与实施组人员数量 n1 相等。
c) 测评组人员要求如下:
1) 应具备测评所需基本能力(如阅读特定语言文字,色觉正常、听觉无障碍等);
2) 宜具备视觉大模型基本知识(如明确所测评大模型的输入、输出样式)。
7.5 指标计算方法
视觉大模型第 6 章通用视觉大模型测评指标结果的计算方法见表 1。
| 类别 | 任务 | 计算方法 |
| 视觉理解 | 静态图像分类 | TOP1准确率或TOP5准确率(见C.1) |
| 静态语义分割 | 交并比和平均像素准确率(见C.1) | |
| 静态实例分割 | 像素准确率和交并比(见C.1) | |
| 目标检测 | 固定交并比(≥0.5)条件下的平均精确率(见C.1) | |
| 旋转检测 | 多边形交并比(见C.1) | |
| 异常检测 | 对于异常检出效果,使用漏检率、误检率(见C.1)和准确率(按GB/T 45288.2—2025中A.1.1描述计算);对于异常定位效果,使用交并比(见C.1) | |
| 实例识别 | 识别率、误识率和漏识率(见C.1) | |
| 视觉分析 | 动态图像分类 | TOP1准确率或TOP5准确率(见C.1) |
| 事件/行为检测 | 准确率(按GB/T 45288.2—2025中A.1.1描述计算)和时间交并比(见C.1) | |
| 位姿识别 | 平均精确率(mAP)或关键点相似度(见C.1) | |
| 目标跟踪 | 多目标跟踪准确率(见C.1) | |
| 变化检测 | 识别率、误识率和漏识率(见C.1) |
附录 A(资料性) 多模态视觉大模型
A.1 视觉交互
A.1.1 图像描述
用于图像描述任务的计算机视觉大模型具备以下能力:
a) 能输入描述指令,对给定图像或视频,输出词语或预先定义的标识,以描述类型或特征;
b) 能输出自然语言描述的类型或特征。
A.1.2 图文问答
用于图文问答任务的计算机视觉大模型具备以下能力:
a) 能理解图像及文字混合输入或包含文字的图像,输出对应的类型或特征,如交互检测;
b) 能回答 a)中包含的问题(如有);
c) 能输出自然语言表达,描述图文输入的类型、特征或回答图文输入中的问题。
A.1.3 视觉内容多轮对话
用于视觉内容多轮对话任务的计算机视觉大模型具备以下能力:
a) 能对输入图像的内容、类型或蕴含意义等输出标识符,完成至少 2 轮交互;
b) 能提供使用自然语言完成对话的能力;
c) 能对输入视频的内容、类型或蕴含意义等输出标识符,完成至少 2 轮交互。
A.1.4 交互式分割
用于交互式分割任务的视觉大模型具备以下能力:
a) 具备自然语言、点击、划线或画框等形式的交互方式;
b) 能支持至少两轮交互。
A.1.5 内容特征检测
用于内容特征检测任务的计算机视觉大模型具备以下能力:
a) 能通过自然语言输入待检测的内容特征;
b) 能从图像检测并输出包含特定特征内容(如数据、颜色、形状等);
c) 能输出相关物体的边界框;
d) 能从视频中识别 a)中要求的内容,返回起止时间。
A.1.6 表格理解
用于表格理解任务的计算机视觉大模型具备以下能力:
a) 能根据自然语言指令,理解给定图像或视频中的一个表格,输出表格内容对应的类型或描述标识;
b) 能理解给定图像或视频中的一个表格,输出自然语言描述表格中的内容;
c) 能从给定图像或视频中的一个表格提取必要信息,回答自然语言描述的问题;
d) 能从给定图像或视频中的一个表格提取必要信息,实施计算;
e) 能从给定图像或视频中的一个表格提取必要信息,预测特定数据序列的变化趋势;
f) 能从给定图像或视频中的多个关联表格提取信息,完成 a)~e)规定的任务。
A.1.7 关系检测
用于实现关系检测任务的计算机视觉大模型具备以下能力:
a) 能根据自然语言指令,检测图像或视频中多个物体之间,人员与物体之间,多个人员之间的空间关系(如前后关系、上下关系、并列关系等),输出关系种类;
b) 能检测图像或视频中多个物体之间,人员与物体之间,多个人员之间的逻辑关系(如动作交互关系、蕴含关系等),输出关系种类;
c) 能检测存在遮挡的图像或视频中多个物体之间,人员与物体之间,多个人员之间的空间或逻辑关系,输出关系种类;
d) 能输出自然语言,描述关系。
A.1.8 数学计算
用于数学计算任务的计算机视觉大模型具备以下能力:
a) 能根据自然语言指令,按图像或视频中包含的印刷体计算式,实施计算并输出结果;
b) 能根据图像或视频中包含的手写体计算式,实施计算并输出结果;
c) 能根据图像或视频中包含的计算式和相关图形,实施计算并输出结果;
d) 能回答或计算图像或视频中包含的以自然语言描述的数学问题;
e) 能输出数学过程相应的计算或推理依据及结果。
A.2 视觉生成
A.2.1 文本生成图像
用于文本生成图像任务的计算机视觉大模型具备以下能力:
a) 能提供自然语言指令输入,用于指定图像生成要求;
b) 能提供负向提示词输入,避免生成图像中出现用户明确指定的排斥元素;
c) 能提供尺寸控制,通过指令调整生成图像的尺寸比例和分辨率。
A.2.2 图像补全
用于图像补全任务的计算机视觉大模型具备以下能力:
a) 能接受标识符或自然语言输入,指定图像补全区域的内容或风格;
b) 能基于生成内容填补形状规则的缺失区域,输出补全后的图像;
c) 能基于生成内容填补形状不规则的缺失区域,输出补全后的图像;
d) 能在缺失区域面积占原图面积不小于 10% 的情况下,完成补全任务;
e) 能基于给定的补全用图,完成补全任务。
A.2.3 视频补全
用于视频补全任务的计算机视觉大模型具备以下能力。
a) 能接受标识符或自然语言输入,指定视频补全区域的内容或风格。
b) 缺失帧补充:
1) 能完成生成及插帧任务(缺帧率不小于 25%),提升给定视频帧率到至少 24 帧/s;
2) 能完成视频内容补全任务,补全时长不小于 1 s;
3) 能保持补全内容与原有内容的逻辑一致性。
c) 视频帧图像补全:
1) 单帧补全时,符合 A.2.1.1 a)~e);
2) 连续多帧补全时,能支持保持补全内容的逻辑一致性。
A.2.4 超分辨率
用于超分辨率任务的计算机视觉大模型具备以下能力:
a) 能接受标识符或自然语言输入,指定视频选定区域及放大比例;
b) 能提供图像或视频的同宽高比放大;
c) 能提供图像或视频中选定区域的同比例放大;
d) 放大比例不小于 10%;
e) 能提供视频(帧率不小于 25%)的实时放大。
A.2.5 语义扩展
用于语义扩展任务的计算机视觉大模型具备以下能力:
a) 能接受自然语言或符号命令,指定扩展的内容;
b) 能沿图像边缘扩展输入图像;
c) 能向前或向后扩展输入视频。
A.2.6 物体替换
用于物体替换任务的计算机视觉大模型具备以下能力:
a) 能接受标识符或自然语言输入,指定物体替换区域;
b) 给定物体图像,能替换输入图像中的指定区域或物体;
c) 给定物体图像或视频,能替换输入视频中的指定物体;
d) 替换后具有逻辑一致性,如替换后的物体与原场景的光照、阴影、透视关系一致。
A.2.7 风格迁移
用于风格迁移任务的计算机视觉大模型具备以下能力:
a) 能根据给定自然语言、图像或视频,指定目标迁移风格;
b) 能提供至少一种目标风格,如写实、复古、科技、动画等;
c) 能提供视频风格迁移。
A.2.8 图像合成
用于图像合成任务的计算机视觉大模型具备以下能力:
a) 能根据给定的自然语言或图像,指定图像合到另一张图像的位置和方式;
b) 能自动化对齐输入图像和目标图像的几何特征,形成融合良好的合成数据;
c) 能缝合带有内容重叠部分的图像。
A.2.9 图像融合
用于图像或视频融合任务的计算机视觉大模型具备以下能力。
a) 图像融合:
1) 能根据自然语言描述的要求,融合图像;
2) 能将给定物体的图像融入输入图像;
3) 能将给定背景的图像融入输入图像;
4) 能保持融入后图像的逻辑一致性。
b) 视频融合:
1) 能根据自然语言描述的要求,融合视频;
2) 能将给定物体的图像或视频,融入输入视频;
3) 能将给定背景的图像或视频,融入输入视频;
4) 能保持融入后视频的逻辑一致性。
A.2.10 元素去除
用于元素去除任务的计算机视觉大模型具备以下能力:
a) 能根据自然语言要求实施去除操作;
b) 能至少去除输入图像中的一个给定类别的物体或人员,并补全图像;
c) 能去除输入图像中的多个给定类别的物体或人员,并补全图像;
d) 能去除视频中的一个或多个给定类别的物体或人员,并补全视频。
A.3 测评结果计算方法
多模态视觉大模型测评指标结果的计算方法见表 A.1。
| 类别 | 任务 | 计算方法 |
| 视觉交互 | 图像描述 | 平均主观总分(见C.2.1)、CIDEr指标(见C.1.12)或BLEU指标(按GB/T 45288.2—2025中A.1.5) |
| 图文问答 | 准确率(按GB/T 45288.2—2025中A.1.1描述计算)或Rouge-L指标(按GB/T 45288.2—2025中A.1.6描述计算) | |
| 视觉内容多轮对话 | 平均主观总分(见C.2.1)和滑动窗口对话相关性分数(见C.2.2) | |
| 交互式分割 | 最小交互次数、准确率、交并比(见C.1) | |
| 内容特征检测 | 准确率(按GB/T 45288.2—2025中A.1.1描述计算) | |
| 表格理解 | 准确率(按GB/T 45288.2—2025中A.1.1描述计算)或平均主观总分(见C.2.1) | |
| 关系检测 | 准确率(按GB/T 45288.2—2025中A.1.1描述计算) | |
| 数学计算 | 准确率(按GB/T 45288.2—2025中A.1.1描述计算)或平均主观总分(见C.2.1) | |
| 视觉生成 | 文本生成图像 | 平均主观总分(见C.2.1) |
| 图像补全 | 平均主观总分(见C.2.1) | |
| 视频补全 | 平均主观总分(见C.2.1) | |
| 超分辨率 | 平均主观总分(见C.2.1) | |
| 语义扩展 | 平均主观总分(见C.2.1) | |
| 物体替换 | 平均主观总分(见C.2.1) | |
| 风格迁移 | 平均主观总分(见C.2.1) | |
| 图像合成 | 图像相似度(见C.1.10)或平均主观总分(见C.2.1) | |
| 图像融合 | 平均主观总分(见C.2.1) | |
| 元素去除 | 平均主观总分(见C.2.1) |
附录 B(资料性) 专用视觉模型
B.1 专用测量
B.1.1 距离测量
用于距离测量任务的计算机视觉模型具备以下能力:
a) 能测量图像中给定两个点之间的三维空间直线距离;
b) 能测量图像中给定两个物体间的最短测地线距离;
c) 能测量图像中给定物体与拍摄视点(如摄像机)间的距离;
d) 能测量视频中给定物体在特定时间段内的运动位移距离;
e) 在不同环境光照、不同物体表面反射性等情况下具备测量距离的能力。
B.1.2 速度测量
用于速度测量任务的计算机视觉模型具备以下能力:
a) 能测量视频中给定物体在三维空间中的运动速度;
b) 在不同环境光线、不同物体表面反射性、遮挡等情况下具备测量运动速度的能力;
c) 具备同时测量同一图像中至少两个物体的运动速度的能力。
B.1.3 对象计数
用于对象计数任务的计算机视觉模型具备以下能力:
a) 能测出图像或视频中给定类型物体的数量;
b) 能在遮挡、不同环境光线等情况下测出给定类型物体的数量。
B.2 专用识别
B.2.1 光学字符识别
用于光学字符识别任务的计算机视觉模型具备以下能力:
a) 能识别印刷体、手写体文字;
b) 能识别不少于五种证件(如身份证、行驶证、护照、银行卡、营业执照、车牌、道路运输证、居民户口簿等)中的文字;
c) 能识别不少于五种票据(如增值税发票、定额发票、出租车发票、火车票、车辆高速通行费发票)中的文字;
d) 能识别不少于三种行业单据中的文字(如物流电子面单、财务报表、银行单据等);
e) 能识别印章中的文字;
f) 能提取文档或表格图像中的信息,输出键值;
g) 能识别在扭曲、倾斜等情况下图像(如证件)中的文字;
h) 能识别不少于三个语种的字符;
i) 能使用识别率、误识率或漏识率(见附录 C)衡量识别效果。
B.2.2 人脸识别
用于人脸识别任务的计算机视觉模型具备以下能力:
a) 能检测图像或视频中的人脸,并输出位置;
b) 能识别人脸,输出标识(如人员名字或 ID 等);
c) 能提供人脸比对,判断最少两张图像中的人脸是否关联同一标识;
d) 能提供基于人脸的搜索,输出相似的多张人脸图像的标识;
e) 能提供图像或视频中的人物活体检测;
f) 能提供不少于三种人种、年龄或性别的人脸识别。
注:因隐私保护等安全要求,人脸识别任务不直接输出人脸图像数据。
B.2.3 视觉同步定位与建图(VSLAM)识别
用于 VSLAM 识别任务的计算机视觉模型具备以下能力:
a) 能通过感知数据输入接收来自摄像头的图像序列,摄像头推荐双目或深度摄像头;
b) 能通过前端视觉里程计处理连续的图像,进行初步的位姿估计和地图创建;
c) 能通过后端优化面向不同时刻视觉里程计测量的相机位姿及回环检测进行优化,纠正前端估计导致轨迹漂移的位姿累积误差,计算出全局的位姿和地图;
d) 能通过回环检测判断是否到达之前的位置,一旦检测出来,说明这两个位姿很接近,从而大幅度修正从回环点到当前点的轨迹漂移,获得一个全局一致的地图;
e) 能根据优化后的摄像头位姿和所有的观测数据,生成最终地图。
注 1:VSLAM 识别用于完成定位和建图这两项任务。
注 2:VSLAM 定位实时估计自身在环境中的六自由度位姿,即三维位置(X,Y,Z)和三维朝向(横滚,俯仰,偏航)。
注 3:VSLAM 建图是根据观测到的图像数据,增量式地构建一个环境的空间模型(三维地图)。
B.2.4 条形码识别
用于条形码识别任务的计算机视觉模型具备以下能力:
a) 能检测图像或视频中的条形码,并返回其出现时间和位置;
b) 能识别并解析条形码中的编码信息;
c) 能支持不少于 1 种常见一维条形码格式,如 Code 128、EAN、UPC 等;
d) 能支持不少于 1 种常见二维条形码格式,如 QR Code、Data Matrix、PDF417 等;
e) 能在不同环境光线、不同物体表面反射性、遮挡、倾斜、扭曲等复杂条件下的识别;
f) 能在同一图像或视频帧中同时识别并区分多个条形码,也即多码识别;
g) 能提供二维码或条码与业务语义的关联解析(如票据、物流单、商品、证照等场景)。
B.3 测评结果计算方法
专用视觉模型测评指标结果的计算方法见表 B.1。
| 类别 | 任务 | 计算方法 |
| 专用测量 | 距离测量 | 平均绝对值百分比误差(见C.1) |
| 速度测量 | 平均绝对值百分比误差(见C.1) | |
| 对象计数 | 平均绝对值百分比误差(见C.1) | |
| 专用识别 | 光学字符识别 | 识别率、误识率或漏识率(见C.1) |
| 人脸识别 | 识别率、误识率或漏识率(见C.1) | |
| 视觉同步定位与建图 | 绝对轨迹误差(见C.1) | |
| 条形码识别 | 识别率、误识率或漏识率(见C.1) |
附录 C(规范性) 测评指标计算方法
C.1 客观测评指标
C.1.1 TOP1 准确率和 TOP5 准确率
TOP1 准确率按公式(C.1)计算。
Acc_TOP1 = (N_ATOP1)/N ×100 %(1)
式中:
N_ATOP1 第 1 预测结果即是正确预测的数量;
N 预测总数量。
TOP5 准确率按公式(C.2)计算。
Acc_TOP5 = (N_ATOP5)/N ×100 %(2)
式中:
N_ATOP5 前 5 预测结果存在正确预测的数量;
N 预测总数量。
C.1.2 交并比
交并比按公式(C.3)计算。
IoU = (B1 capB2)/(B1 cupB2)(3)
式中:
IoU——交并比;
B1 标注的边界框;
B2 预测的边界框。
注:在事件、动作等有时间延续性的检测、识别场景中,B
1 和 B
2 分别指标注和预测的时域边界范围,此时指标称为“时间交并比”。
C.1.3 识别率
识别率按公式(C.4)计算。
R = (NT)/N ×100 %(4)
式中:
NT 正确识别的样本数量;
N 识别的样本总量。
C.1.4 误识率
误识率按公式(C.5)计算。
FAR = (NF)/N ×100 %(5)
式中:
NF 识别错误的样本数量;
N 识别的样本总量。
注 1:在人脸识别中,误识率的分子是错误地将两张不属于同一人的图像接受为同一人的样本数量。
注 2:在变化检测中,误识率的分子是错误地认定有变化的样本数量。
注 3:在物体识别中,误识率的分子是错误地将两个不属于同一物体的图像或视频接收为同一物体的样本数量。
注 4:在光学字符识别中,误识率的分子是将特定字符识别为错误字符的样本数量。
C.1.5 漏识率
漏识率按公式(C.6)计算。
FRR = (NU)/N ×100 %(6)
式中:
NU 未能识别的样本数量;
N 识别的样本总量。
注 1:在人脸识别中,漏识率的分子是系统未能识别出目标人脸的样本数量。
注 2:在变化检测中,漏识率的分子是未检出而实际发生变化的样本数量。
注 3:在物体识别中,漏识率的分子是未检出属于同一物体的两张图像或两段视频的样本数量。
注 4:在光学字符识别中,漏识率的分子是未识别出特定字符的样本数量。
C.1.6 平均绝对值百分比误差
平均绝对值百分比误差按公式(C.7)计算。
MAPE = 1/N Σi=1N | (Ai - Pi)/(Ai) |(7)
式中:
MAPE——平均绝对值百分比误差;
Ai 第 i 个样本的真实值;
Pi 第 i 个样本的预测值;
N 样本总数。
C.1.7 平均精确率
平均精确率按公式(C.8)计算。
mAP = 1/C Σi=1c (TPi)/(Ni) ×100 %(8)
式中:
mAP 平均精确率;
C 类别总数;
i 第 i 类 ;
Ni 第 i 类的预测数;
TPi 第 i 类的正确预测数。
C.1.8 关键点相似度
关键点相似度按公式(C.9)计算。
OKS (q, p) = (Σi [ exp ((- dq,p,i2)/(2 timessp2 × σi2)) × δ (vp,i > 0) ])/(Σi [ δ (vp,i > 0) ])(9)
式中:
OKS ——关键点相似度;
q 预测值中某个人或物体的标识;
p 真值中某个人或物体的标识;
dq,p,i 预测值中第 q 个人或物体关键点 i 与真值中第 p 个人或物体关键点 i 之间的欧氏距离;
i 某个人或物体的关键点标识;
vp,i>0 表示关键点 i 存在可见性,即在图像或视频中可见;
Sp ——人或物体所占面积的平方根,根据真值中的标注框计算得到;
σi 第 i 个关键点的归一化因子,通过对样本集合中所有真值关键点人工标注与真实值标准差,一般用作常数。
注:公式(C.9)在 1 张图像中真值存在 M 个人或物体,预测 N 个人或物体时,对 pinM 与 qinN 的关键点 i计算相似度得到 MtimesN 矩阵,再选择相似度最大的作为预测值。若图像预测值仅有 1 个人或物体,则 N=1 ,标识 q 通常省略。若图像真值仅有 1 个人或物体,则 M=1 ,标识 p 通常省略。
C.1.9 平均像素准确率
平均像素准确率按公式(C.10)计算。
PA = 1/N ΣiN (PN_Acci)/(PNi) ×100%(10)
式中:
PA 平均像素准确率;
i 第 i 个样本;
N 样本总数;
PNAcc —— 第 i 个样本中所有正确归类(划分区域)的像素数;
PNi 第 i 个样本的总像素数。
C.1.10 图像相似度
图像相似度按公式(C.11)计算。
SSIM (x, y) = ((2 μx μy + C1) ×(2 δxy + C2))/((μx2 + μy2 + C1) ×(δx2 + δy2 + C2))(11)
式中:
SSIM ( x,y ) ——缝合后图像 x 与真实值图像 y 的图像相似度;
μx 或 μy 图像 x 或 y 的信号均值;
δx 或 δy 图像 x 或 y 的信号标准差;
δxy 信号的协方差;
C1 正值常数,用于避免公式出现除以零的异常。 C1=(K1timesL)×(K1timesL) ,默认 K1= 0.01,L=255;
C2 正值常数,用于避免公式出现除以零的异常。 C2=(K2timesL)×(K2timesL) ,默认 K2= 0.03,L=255。
C.1.11 多目标跟踪准确率
多目标跟踪准确率按公式(C.12)计算。
MOTA = (FN + FP + IDSW)/GT ×100 %(12)
MOTA ——多目标跟踪准确率;
FP 视频误报总数,即对每帧的误报数量求和;
FN 视频漏报总数,即对每帧的漏报数量求和;
IDSW ——视频目标 ID 切换总数,即对每帧发生的跟踪目标 ID 切换数量求和;
GT 视频目标总数,即对每帧的目标数量求和。
C.1.12 共识图像描述评估
共识图像描述评估按公式(C.13)计算。
CIDEr = TF - IDF(13)
CIDEr ——基于共识的图像描述评估;
TF 词频(Term Frequency),也称 n⁃gram 频率,也即 n⁃gram 在文件出现的频率;
IDF —— 反文档频率(Inverse Document Frequency)。
C.1.13 绝对轨迹误差
绝对轨迹误差按公式(C.14)计算。
ATE = √(1/N Σi=1N | trans (Pi-1 SQi) |2)(14)
ATE 绝对轨迹误差;
Pi 第 i 时刻设备的真实参考位姿(Ground Truth)变换矩阵;
S 对应时间戳对齐后的相似/刚体变换矩阵,用于将估计轨迹映射至真实轨迹坐标系下;
Q
i 第 i 时刻设备的估计位姿变换矩阵;
trans ( ·) ——特征提取算子(Translation Vector),表示提取给定四阶齐次变换矩阵中的三维平移向量分量;
N 参与误差计算的有效位姿序列总帧数。
C.2 主观测评指标
C.2.1 平均主观总分
平均主观总分按公式(C.15)计算。
G = (Σi=1k Ri)/N (15)
G ——平均主观总分;
R
i ——第 i 个评价人员的给分(5 分制,自然数 1 分~5 分)。其中,多轮对话使用滑动窗口对话相关性分数评分(见 C.2.2),其他情况使用 MOS 评分(按 GB/T 45288.2 中 A.2 描述计算);
N ——主观评分数量。
C.2.2 滑动窗口对话相关性分数
滑动窗口对话相关性分数按公式(C.16)计算。
SWRw = (Σr=1R resprw)/R(16)
SWR w ——滑动窗口对话相关性分数;
w 滑动窗口大小;
R —— 对话轮数(模型回答次数);
resp 模型在 1 次对话中的第 r 个回复,此回复需要在滑动窗口 w 中,由人工验证相关性。如上文对话轮数小于 w ,则以该轮数作为窗口。
评论