


前言
本文件按照 GB/T 1.1—2020《标准化工作导则 第1部分:标准化文件的结构和起草规则》的规定起草。
本文件是 GB/T(Z)45288《人工智能 大模型》的第5部分。GB/T(Z)45288已经发布了以下部分:
第1部分:通用要求;
第2部分:评测指标与方法;
第3部分:服务能力成熟度评估;
第4部分:计算机视觉大模型;
第5部分:多模态大模型;
第7部分:语音大模型。
请注意本文件的某些内容可能涉及专利。本文件的发布机构不承担识别专利的责任。
本文件由全国信息技术标准化技术委员会(SAC/TC 28)提出并归口。
本文件起草单位:浙江大学、中国电子技术标准化研究院、浦江国家实验室、北京智源人工智能研究院、蚂蚁科技集团股份有限公司、北京智谱华章科技股份有限公司、北京航空航天大学、阿里云计算有限公司、华为云计算技术有限公司、科大讯飞股份有限公司、上海商汤智能科技有限公司、清华大学、启元实验室、中国移动通信集团有限公司研究院、中国电力科学研究院有限公司、国能数智科技开发(北京)有限公司、中国电信股份有限公司北京研究院、南方电网数字电网集团有限公司、中国航天科技体系与创新研究院、中国电信股份有限公司上海研究院、杭州电子科技大学、杭州师范大学、华东师范大学、中国移动通信集团有限公司、北京百度网讯科技有限公司、中国科学院软件研究所、杭州海康威视数字技术股份有限公司、北京交通大学、北京邮电大学、安徽大学、上海计算机软件技术开发中心、浙江大华技术股份有限公司、北京生数科技股份有限公司、北京市公安局人工智能安全研究中心、浙江省质量科学研究院、中科紫东太初(北京)科技有限公司、中移(杭州)信息技术有限公司、中移(苏州)软件技术有限公司、北京中科金得助智能科技有限公司、国投智能信息科技股份有限公司、山东省人工智能研究院、讯飞医疗科技股份有限公司、浪潮软件科技有限公司、浪潮通信信息系统有限公司、中电信数智科技有限公司、中移雄安信息通信科技有限公司、中兴通讯股份有限公司、自然语义(青岛)科技有限公司、哈尔滨工业大学、中车长春轨道客车股份有限公司、中电科大数据研究院有限公司、上海燧原科技股份有限公司、上海文鳐信息科技有限公司
本文件主要起草人:吴飞、鲍薇、况琨、曹晓琦、孙曦、李建欣、张圣宇、石羡、杨熙、冯涛、刘祥龙郑若琳、杨彤晖、吴庚、吴涛、董建、陶建华、王志栋、刘伟东、陈晰、杨旭、王峰、梁寿愚、高东辉、焦若丹李皓月、韩韬、吴洋洋、李晋伟、李孟择、范佳宣、刘卫卫、蒋慧、郑子木、范存航、汪群博、于佃海、魏简康凯、刘颖、孟凡芹、刘艾杉、王嘉凯、左兴权、张丹丹、阙锦龙、王烨东、谭文明、洪立斌、蔡海滨殷兵、单珂、陈敏刚、尤梦祥、孔维生、黄现翠、杨语澈、王彦功、肖红梅、曹汐、杨经纬、王金桥、付涛李旭东、高歌、沈芷月、李斌斌、孟令中、章古月、秦日臻、武鑫鑫、张学聪、郑庆国、孙燕群、逄菲、李哲欣李海峰、赵孝武、任祥臣、余楷、梅敬青、仲凯韬
引言
多模态大模型作为人工智能领域的前沿技术,有效整合了文本、视觉、语音等多种模态的信息处理能力,克服了传统单一模态模型在综合理解、跨模态推理和任务泛化等方面的局限性,已成为产学研的焦点,并得到了国内外企业、系统解决方案供应商、研究机构的广泛关注、深入研究与实际应用。本文件旨在规范现有多模态大模型,并推动不同模态间的知识迁移与融合,降低多模态大模型的开发成本,支撑人工智能在更广泛领域赋能经济发展和社会进步。GB/T(Z)45288《人工智能 大模型》旨在规定通用大模型的技术要求、评测指标和服务能力,拟由九个部分构成
第1部分:通用要求。目的在于确立大模型的参考架构,规定通用技术要求
第2部分:评测指标与方法。目的在于确立大模型的评测指标,描述评测方法。
第3部分:服务能力成熟度评估。目的在于给出大模型服务能力成熟度等级及评估方法。
第4部分:计算机视觉大模型。目的在于确立计算机视觉大模型的参考框架,规定技术要求,描述测试方法。
第5部分:多模态大模型。目的在于规定多模态大模型的参考架构和技术要求。
第6部分:代码大模型。目的在于定义代码大模型的概念和功能,规定技术要求和测试方法。
第7部分:语音大模型。目的在于定义语音大模型的概念和功能,规定技术要求和测试方法
第8部分:时间序列大模型。目的在于定义时间序列大模型的概念和功能,规定技术要求和测试方法。
第9部分:图大模型。目的在于定义图大模型的概念和功能,规定技术要求和测试方法。
多模态大模型
1 范围
本文件确立了多模态大模型的参考架构,并规定了多模态大模型数据、训练、推理和应用等的技术要求。
本文件适用于多模态大模型系统的设计、开发、部署及应用
2 规范性引用文件
下列文件中的内容通过文中的规范性引用而构成本文件必不可少的条款。其中,注日期的引用文件,仅该日期对应的版本适用于本文件;不注日期的引用文件,其最新版本(包括所有的修改单)适用于本文件。
GB/T 41818—2022 信息技术 大数据 面向分析的数据存储与检索技术要求
GB/T 41867 信息技术 人工智能 术语
GB/T 42135—2022 智能制造 多模态数据融合技术要求
GB/T 45288.1 人工智能 大模型 第1部分:通用要求
GB 45438 网络安全技术 人工智能生成合成内容标识方法
GB/T 45652 网络安全技术 生成式人工智能预训练和优化训练数据安全规范
GB/T 45654 网络安全技术 生成式人工智能服务安全基本要求
GB/T 46800 生成式人工智能技术应用社会影响 评估指南
3 术语和定义
GB/T 41867、GB/T 45288.1界定的以及下列术语和定义适用于本文件。
3.1 多模态大模型 multimodal large-scale model
基于机器学习技术,实现对文本、图像、音频、视频等多种模态数据的处理、理解与生成,支持多种模态数据的联合建模的大语言模型。
注:多模态大模型能从不同模态的数据中提取信息,并将这些信息进行有效融合,从而完成跨模态的任务,如图文生成、视频理解、多模态情感分析等。本文件中多模态大语言模型在广义上等同于多模态大模型
3.2 多模态大模型系统 multimodal large-scale model system
利用多模态大模型的功能,结合其他必要组件完成多模态任务的软件系统。
注:其他必要组件包括用于数据采集与预处理的前端模块、用于任务调度与资源管理的中间件、用于结果呈现与交互的用户界面,以及用于保障系统稳定运行的监控和安全模块等。这些组件与多模态大模型协同工作,共同构成一个完整的多模态应用解决方案。多模态任务一般指需要人工智能模型同时理解和处理来自多种不同类型数据(模态)的信息,并在此基础上完成的复杂任务,如结合视觉和语言信息的视觉问答任务、结合音频和视觉的视听语音识别任务等
4 缩略语
下列缩略语适用于本文件。
AdamW:带权重衰减的自适应矩估计(Adaptive moment estimation with Weight decay)
BF16:Brain浮点16位(Brain Floating point 16-bit)
FP16:16位浮点数(16-bit Floating point)
JSON:JavaScript对象表示法(JavaScript Object Notation)
KL散度:Kullback-Leibler散度(Kullback-Leibler divergence)
LAMB:分层自适应矩批量训练优化器(Layer-wise Adaptive Moments optimizer for Batch training)
LoRA:低秩适配 (Low-Rank Adaptation)
5 多模态大模型系统参考架构
多模态大模型系统的参考架构见图1,包括以下组成部分:
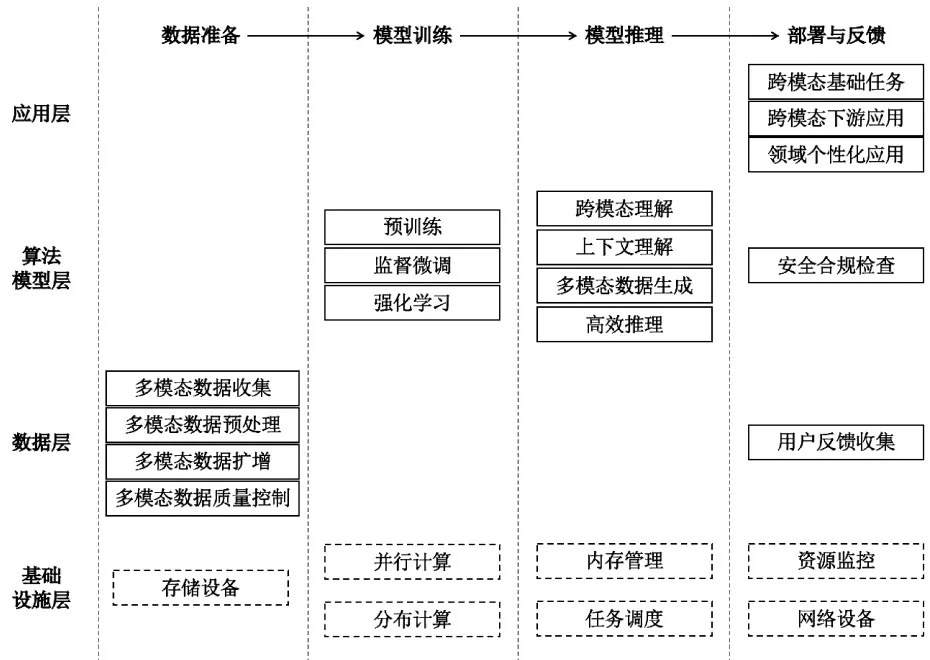
a) 基础设施层:涵盖数据准备阶段的存储设备,涵盖模型训练阶段的并行计算和分布计算设备,涵盖模型推理阶段的内存管理和任务调度,并涵盖部署与反馈阶段的资源监控和网络设备,虚线框的内容本文件不做规定;
b) 数据层:涵盖数据准备阶段的多模态数据收集、预处理、扩增和质量控制,并涵盖部署与反馈阶段的用户反馈收集;
c) 算法模型层:涵盖模型训练阶段的预训练、监督微调、强化学习等训练算法,涵盖模型推理阶段的跨模态理解、上下文理解、多模态数据生成、高效推理等关键技术算法,并涵盖部署与反馈阶段的安全合规检查;
d) 应用层:涵盖部署与反馈阶段的跨模态基础任务、跨模态下游应用和领域个性化应用。
6 多模态大模型数据要求
6.1 多模态数据类型要求
6.1.1 基本数据类型
根据多模态大模型的使用需要,训练和推理所使用的数据应覆盖两种及以上不同模态。数据模态应包含但不限于以下类型:
a) 文本;
b) 图像;
c) 视频;
d) 音频;
e) 三维数据。
6.1.2 多模态数据组
在上述数据类型的基础上,多模态大模型应处理由两种及以上模态组成的输入数据,典型组合形式包括但不限于:
a) 图像-文本;
b) 视频-文本;
c) 音频-文本;
d) 视频-音频;
e) 三维数据-文本;
f) 视频-图像-文本。
6.2 多模态大模型预训练阶段数据要求
多模态大模型预训练阶段数据符合以下要求
a) 安全合规要求:应符合 GB/T 45654、GB/T 45652的规定。
b) 数据收集要求:
1) 应制定明确的数据需求规划,包括数据类型、规模、质量标准和安全性要求;
2) 收集的数据应覆盖各类涉及多模态交互的应用场景,保证数据分布的广泛性和代表性;
3) 应确保多模态数据具有自然的语义关联性,维护原始的跨模态对应关系;
4) 应对数据来源进行资质审核并留存完整记录,确保数据获取的合法合规性;
5) 收集的数据应来源于多类不同特性的传感器,同一模态应覆盖不少于3种不同工作原理或核心参数的采集设备(特殊场景下可根据应用需求说明并经评估后减少),例如图像数据可来自监控录像、移动终端拍照、无人机航拍、卫星遥感等,以保证数据在成像机理、分辨率、视角、光照条件及场景尺度上的差异性和代表性,从而提升模型对真实世界多源输入的鲁棒性与泛化能力;
6) 应保证数据分布与真实场景分布相符,兼顾不同模态、场景、群体的样本平衡性
c) 数据扩增要求:
1) 应通过人工标注校验或自动化评测等方式,从数据质量、模态内准确性、模态间一致性、数据多样性等角度进行质量控制;
2) 合成数据应明确生成逻辑,避免因算法偏差导致模态间语义失真或引入虚假相关性;扩增过程应保留原始数据的分布特性,不引入非自然模态关联;
3) 应提高训练任务的难度,逐步增加对跨模态推理、模态间关系理解以及信息融合的要求,以增强模型的多模态任务学习与执行能力。
d) 数据质量控制要求:
1) 应对数据进行基本预处理,以符合 GB/T 42135—2022中7.2的要求;
2) 数据标注具备跨模态一致性与交互性;一方面,同一组数据中的不同模态应具备相似的语义信息,即在跨模态标注时,确保各模态(如图像和对应的文本描述、音频和其转录文本)表达的内容相符;另一方面,标注应适配跨模态互补与交互的需求,例如图像问答、视频理解等场景中,不同模态之间提供互补信息或通过问答等形式进行语义互动;
3) 预训练数据应使用人工抽测或自动化检测方法,综合估算整体数据质量,特别关注模态间的一致性和数据的语义准确性;
4) 应结合人工审核与自动化工具对数据进行偏见与伦理风险的审查,通过数据过滤、再标注或重采样等方式降低风险,以确保数据符合6.2 a)安全合规要求;
5) 应建立跨模态对齐验证机制,确保不同模态间在语义、时空或上下文层面的对齐精度;例如,在视频-文本对中,动作发生的时间段应与描述文本中的动词时序一致;在图文对中,图像区域与文本指代对象应具备可映射关系;该机制可通过人工评估、跨模态检索召回率或对齐度量指标进行量化验证 6) 多模态训练数据应覆盖多样化的场景、领域和文化背景,避免因模态分布偏斜(如图像以特定地域为主、语音仅含单一语种或口音)导致模型泛化能力下降。数据集应提供模态覆盖率与多样性分析报告,并在必要时通过主动采样或合成增强手段提升均衡性。
e) 数据存储与管理要求:应符合 GB/T 41818—2022中第8章的要求。
6.3 多模态大模型监督微调阶段数据要求
多模态大模型监督微调阶段数据符合以下要求
a) 数据收集要求:
1) 应基于预训练模型能力、落地场景(如教育、医疗、工业等)及任务类型(如跨模态检索、生成、推理等)定向采集数据;
2) 数据采集范围匹配下游任务需求,涉及高敏感领域(如医疗、金融、司法)的数据,应经过行业主管部门合规审查,确保数据来源的合法性与权威性,审查流程应形成书面记录。
b) 数据扩增要求:
1) 数据扩增技术应与目标任务强相关,例如在视觉问答任务中可对图像进行遮挡增强但保持文本问题有效性;
2) 合成数据标注生成规则应与任务适配,避免破坏预训练阶段建立的跨模态关联逻辑;
3) 扩增后数据分布应与真实任务场景一致,避免因过度拟合合成特征导致影响模型泛化性能。
c) 数据质量控制在符合6.2 d)的基础上,还应符合以下要求:
1) 建立任务驱动的多模态标注验证机制,例如在图像描述任务中检查文本与视觉实体的一致性;
2) 平衡不同模态的数据,避免微调后单一模态的数据主导模型决策;
3) 针对高风险任务(如医疗诊断),建立领域专家审核机制,确保每个任务由多名(宜不少于2名)领域专家参与数据审核,并形成共识性审核意见。
d) 数据安全合规要求、数据存储与管理要求应与6.2一致。
6.4 多模态大模型强化学习阶段数据要求
多模态大模型强化学习阶段数据符合以下要求。
a) 数据收集要求:
1) 环境模拟与真实世界数据:强化学习的数据应来源于模拟环境或真实世界;模拟环境应提供安全、可控的测试环境,而真实世界应提供更复杂、更真实的交互场景;
2) 交互记录:数据应包括智能体与环境交互的完整记录,包括状态、动作、奖励和下一个状态。
b) 数据扩增要求:
1) 数据扩增:允许通过数据扩增技术,如改变初始状态、引入随机性或使用不同的策略,增加数据的多样性和丰富性;
2) 合成数据:在某些情况下,尤其是真实数据难以获取或成本高昂时,允许使用合成数据来补充或替代真实数据。
c) 数据质量控制在符合6.2 d)的基础上,还应符合以下要求:
1) 数据清洗:去除异常、错误或不一致的数据,确保数据的准确性和一致性;去除已在模型能力范围的数据,确保数据的有效性;
2) 数据平衡:确保数据集中不同动作或状态的分布是平衡的,避免模型偏向于某些特定的决策。
d) 数据安全合规要求、数据存储与管理要求应与6.2一致。
e) 数据真实性要求:真实世界数据应保证来源可追溯、内容真实有效,不伪造或篡改;模拟环境数据应与真实场景的模态特征、语义关联保持一致性,避免因模拟数据失真导致模型性能偏差,建立数据溯源台账,记录采集时间、地点、设备编号、负责人等关键信息。
6.5 多模态大模型的输入预处理要求
多模态大模型的预处理能力满足以下要求
a) 文本:多模态大模型应通过词法分析器将文本分解为词元,并转化为嵌入向量表示。
b) 图像:应按照 GB/T 42135—2022中7.3 f)的要求提取图像特征。
c) 视频:
1) 应按照 GB/T 42135—2022中7.3 d)的要求处理时间序列关系;
2) 应按照 GB/T 42135—2022中7.3 h)的要求提取视频特征。
d) 音频:应按照 GB/T 42135—2022中7.3 g)的要求提取音频特征。
e) 三维数据:
1) 应提供三维数据的切片处理、体素化处理、下采样等预处理操作,预处理后的三维数据应兼容主流深度学习框架的输入格式;
2) 应提供从三维数据中抽取几何特征的操作,如点云密度、曲率、法向量等;
3) 应提供从三维数据中抽取结构特征的操作,如拓扑关系、层级结构、边界描述等具体特征;
4) 应提供从三维数据中抽取表观特征的操作,如材质、纹理、光照等具体特征。
f) 实时数据流:应提供对连续音视频流的实时预处理能力,包括缓冲区管理、动态分帧和延迟控制。
7 多模态大模型训练要求
7.1 多模态大模型预训练要求
7.1.1 训练目标
多模态大模型的预训练应实现以下一种或多种核心目标:
a) 单模态深度理解:通过自监督学习等方式,使各模态编码器能充分学习并压缩其对应模态数据(如文本、图像、音频)的内在结构与语义信息,获得高质量的特征表示;
b) 跨模态语义对齐:设计统一的预训练任务(如对比学习、掩码跨模态建模等),引导模型建立不同模态信号在语义层面的准确关联与对齐,形成共享的跨模态理解基础;
c) 多模态协同建模:在统一架构下进行联合训练,使模型不仅能关联跨模态内容,更能学习到模态间互补、融合的深层表示,支撑复杂的跨模态推理与生成任务
7.1.2 模型架构要求
多模态大模型应选用具备以下能力的模型架构
a) 单模态编码能力。多模态大模型的单模态编码模块符合以下要求:
1) 根据多模态大模型处理的模态范围,各模态编码模块应有效编码数据原始信息,并转化为高维特征向量;
2) 不同模态编码模块输出的特征向量应映射到语义一致的共享表示空间,并结合模态间的时间、空间对齐机制,为后续的跨模态任务提供基础
b) 跨模态交互能力。多模态大模型的跨模态交互模块通过包括但不限于以下方式,以实现不同模态的交互:
1) 特征向量对齐(早期融合):在表示方式上,应将不同模态的特征向量通过缩放、时间步调整、插值等方式进行向量维度上的对齐;在语义空间上,应将不同模态的特征向量映射到同一个语义空间,并通过拼接、加权等方式实现不同模态数据的交互;
2) 注意力机制(深度融合):应将不同模态的特征向量进行交叉注意力运算,或是先转换为统一的词元表示,再不加区分地进行自注意力运算,实现不同模态数据的交互;
3) 决策融合(晚期融合):多模态大模型分别处理各模态数据后,应通过决策层对输出结果进行整合。
c) 多模态上下文理解。预训练阶段应引入多模态长上下文序列数据,使模型具备捕捉跨模态上下文关联的能力,能理解多模态输入中时序、逻辑及场景层面的深层关联,支持长序列多模态数据的连贯解析与响应(例如,文本与图像/视频的联合上下文长度应不低于基础单模态上下文长度的80%)。
7.1.3 优化与训练策略要求
多模态大模型的优化与训练策略应符合以下要求:
a) 依据模态和输出结果适配常见的损失函数,如对比学习损失、生成式学习的损失等,以达到跨模态语义对齐、跨模态理解等训练效果;
b) 具备平衡不同模态损失的能力,避免训练过程偏向某一模态;
c) 支持多模态掩码补全,即在预训练中引入掩码建模,提升模型的跨模态理解能力:
1) 掩码文本补全:模型利用非文本模态数据中的信息,来预测被掩盖的文本词元;
2) 掩码其他模态补全:掩盖非文本模态数据的部分区域(如图像数据中的块,视频数据中的帧片段),使模型预测被掩盖区域的内容;
3) 掩码比例的确定:根据不同模态数据的冗余度及模型架构特性,设置合理的掩码比例区间,以确保模型能够通过上下文信息有效重建被掩盖的内容;
d) 鲁棒性增强训练:通过引入模态噪声数据、部分模态缺失数据、对抗性样本等进行训练,提升模型对异常输入的适应能力。
7.2 多模态大模型监督微调要求
多模态大模型在微调阶段,通过指令微调的方式以获得执行用户特定指令的能力,涵盖开放式指令、封闭式指令、多步骤指令、条件约束指令、系统指令等类型。在此阶段应具备以下能力:
a) 适应多样化跨模态指令形式:指令涵盖多种多模态任务,并具备自然语言表述的多样性;
b) 多模态多轮对话:针对多轮交互的任务,进行包含多轮对话的指令微调,提升模型对跨轮次变换的追踪能力;
c) 适应跨模态细粒度对齐指令:指令微调数据应包含要求模型进行局部对齐的任务(如目标检测标注、图像区域描述、视频关键帧定位),以确保模型具备空间或时间上的细粒度理解能力;
d) 多模态多任务联合优化:同时优化多个相关的多模态任务,提升模型在不同任务上的跨模态表示和处理能力;
e) 通用能力保持:通过预训练数据重采样、正则项约束等方式避免灾难性遗忘,在提升模型特定多模态任务能力的同时,保持其在通用任务上的能力;
f) 模态平衡:通过过采样、损失函数加权等方式,对预训练过程中的弱势模态进行增强,提升模型充分利用不同模态数据的能力。根据模态重要性评估结果采用1.2倍~1.5倍过采样,过采样后数据总量不超过原始数据的3倍,避免数据冗余,过采样方式包括随机过采样、合成过采样等。
7.3 多模态大模型强化学习要求
多模态大模型在强化学习阶段符合以下要求。
a) 奖励函数设计要求:
1) 应基于人类评分的奖励函数,制定严谨的、多维度的评分标准,以提高不同标注者对图像等模态的评分一致性;
2) 应基于模型的奖励函数,准确预测人类对模型多模态输出组合的偏好分数;
3) 平衡不同模态奖励函数,应根据任务和不同模态的表达强度设置奖励权重调节机制,防止出现单一模态驱动的奖励偏置;
4) 应平衡不同维度奖励函数,包括准确性、相关性、完整性、自然性、模态间一致性等维度,每个维度权重根据任务需求设定。
b) 多模态动作与状态空间定义:应根据多模态大模型处理的模态范围,定义相应的动作与状态空间,并构建决策序列,以便后续进行训练。
c) 训练稳定性:应通过引入 KL散度等方式提高强化学习的训练稳定性,防止模型遗忘通用的多模态理解和生成能力。
7.4 其他要求
多模态大模型还应符合以下训练要求:
a) 轻量级微调,提供 LoRA 等轻量微调方法,实现对局部参数或自定义模块的微调;
b) 模型权重初始化加载与训练模型,支持从已有的单模态或多模态模型中加载部分权重进行训练,加快收敛速度并提升初始性能;
c) 学习率调度,支持预热、余弦退火、线性衰减等学习率调度策略;
d) 优化器配置,支持 AdamW、LAMB等适用于大规模模型训练的优化器,并支持参数分组设置不同学习率;
e) 训练效率优化,支持混合精度训练(FP16/BF16)、梯度累积、梯度检查点等技术,以提升训练效率和降低显存占用;
f) 分布式训练,支持或兼容主流的分布式并行训练策略,包括但不限于数据并行、张量并行、流水线并行及序列并行,以支撑超大规模参数模型的高效训练。
8 多模态大模型推理要求
8.1 跨模态理解要求
多模态大模型在推理阶段的跨模态理解应符合以下要求:
a) 跨模态理解能力,理解不同模态的输入数据,并输出与任务目标相符的一种或多种其他模态响应;
b) 跨模态语义对齐,准确地识别并关联不同模态中的相同或相关概念,建立模态间的语义对应关系,包含词级、句子级、文档级、视频帧级等多粒度语义对齐;
c) 语义融合,有效融合来自不同模态的信息,实现跨模态信息的互补;
d) 模态缺失容错,在部分模态输入缺失或含有噪声时,能识别并使用可靠模态进行推理,并允许用户指定不同模态的权重或优先级,以适应复杂的实际应用场景;
e) 歧义消解能力,能识别多模态输入中的语义歧义(包括单模态内歧义与跨模态语义冲突),通过结合上下文信息、模态间语义验证、常识推理等方式消解歧义,确保对输入数据的准确理解;在交互场景下向用户反馈并请求补充信息;在非交互场景下输出低置信度警告或提供多假设候选结果。
8.2 上下文理解要求
多模态大模型的上下文理解机制应符合以下要求:
a) 长上下文处理能力,具备处理长时间序列(如视频、音频)输入、理解多轮对话上下文的能力,视频输入时长不低于30 min、音频输入时长不低于1 h、多轮对话轮次不低于50轮或总交互 Token数超过模型最大上下文长度的80%,满足任一条件即视为长上下文,支持对长时间序列数据的分段处理与语义连贯性保持,明确长上下文的长度阈值;
b) 模态间上下文融合,具备将不同模态的上下文信息进行整合的能力;
c) 一致性,在输出时间序列的数据(如视频、音频)和进行多轮对话时,时序和语义上具有一致性,采用时序一致性检测算法,视频帧间语义相似度不小于 0.8;多轮对话语义相似度不小于0.85;
d) 上下文存储与检索,具备有效存储上下文信息的能力,以便在推理过程中能方便地检索和利用历史信息。
8.3 多模态生成要求
多模态模型的生成应符合以下要求:
a) 跨模态生成能力,从一种模态的输入生成一种或多种模态的输出;
b) 生成质量,生成符合人类预期和伦理要求的内容,生成内容测评见 GB/T 45288.2—2025的5.2生成能力指标;
c) 时序连贯性,在生成视频、音频等时序数据时,保持时序上的连贯性,且确保关键时序信息不丢失;
d) 生成内容合规要求,生成内容遵守《互联网信息服务深度合成管理规定》等法律法规要求,不生成虚假信息、有害信息、侵犯隐私的信息;对生成的多模态内容进行合规性检测,建立异常内容过滤机制;涉及生成式内容的,明确标注“人工智能生成”,保障用户知情权;
e) 可追踪性,记录生成配置、版本,保证结果可复现;
f) 推理透明度,提供可配置的详细推理模式,在请求时返回跨模态注意力权重分布和中间特征相似度。
8.4 高效推理要求
多模态模型宜采用以下机制进行高效推理:
a) 长序列与大尺寸模态数据处理,提供稀疏注意力、窗口注意力、分块处理等技术,以应对视频高分辨率图像、长音频等超长序列或超大尺寸的输入问题,降低计算复杂度;
b) 并行计算与分布式推理,支持并行或分布式计算,提高多模态模型的推理效率;
c) 高效内存管理,在多模态模型推理过程中有效管理内存资源,包括内存的分配和释放,避免内存泄漏等;
d) 智能缓存机制,对于重复的推理请求或相似的输入数据,在避免信息泄露的基础上,通过缓存机制快速调取之前的多模态模型推理结果;
e) 推理加速机制,根据应用场景明确推理延迟阈值;提供延迟优化方案,在保证推理精度的前提下,降低多模态数据处理的延迟,通用场景推理延迟不超过500 ms,实时交互场景(如虚拟助手)不超过200 ms,高实时场景(如自动驾驶)不超过100 ms;
f) 模型量化,支持半精度、8位精度、4位精度等低精度量化推理,通过降低数值精度减少显存占用并加速计算,在维持模型性能的同时显著提升推理吞吐量。
9 多模态大模型应用与反馈要求
9.1 跨模态基础任务
多模态大模型应用于包括但不限于以下跨模态基础任务:
a) 跨模态转化,将数据从某些模态转化为另外某些模态,且保证转化前后的语义对齐;
b) 跨模态理解,对图像、视频、音频、三维数据等模态进行理解,并输出相应文本描述;
c) 跨模态匹配,计算给定不同模态数据之间的匹配程度;
d) 跨模态整合,借助多模态模型从多个模态的数据中提取与整合信息,并用于后续任务,如辅助决策、推荐系统等;
e) 跨模态推理,基于多模态输入进行逻辑推理与因果推断;
f) 模态补足与修复,在部分模态缺失或噪声情况下,通过其他模态信息补足或修复数据;
g) 跨模态纠错,识别并修正单一模态或跨模态数据中的错误信息(如文本错别字、图像标注错误)。
9.2 跨模态下游应用
多模态大模型应用于包括但不限于以下跨模态下游应用:
a) 跨模态对话,通过文本、图像等模态的输入进行多轮自然对话;
b) 跨模态生成,根据文本(或图像等其他模态)的描述生成图像、视频、音频、三维数据等模态的数据;
c) 跨模态检索,根据文本(或图像等其他模态)描述从数据库或网络等环境中查找到相应的其他模态的数据;
d) 跨模态编辑,根据文本(或图像等其他模态)的描述,将给定的图像、视频、音频、三维数据等模态的数据进行相应的编辑;
e) 多模态知识图谱,利用多模态模型整合不同模态的信息,构建知识图谱以捕捉实体及其关系。
9.3 领域个性化应用
多模态大模型应用于包括但不限于以下领域个性化应用:
a) 自动内容创作,利用多模态模型自动生成文字、图片和视频等,在社交、娱乐、文化传播等领域辅助内容创作;
b) 虚拟助手,利用多模态模型提供语音识别、视频解析和图像理解的综合服务;
c) 智能监测,结合监控视频、无人机航拍视频、音频等数据,利用多模态模型提供实时的安全监测和事件检测,应建立监测性能评估体系,评估维度应包含时效性(从数据输入到结果输出的端到端延迟)、准确性(真阳性率与假阳性率的平衡)、鲁棒性(在噪声/遮挡等干扰条件下的性能保持能力),评估方法应符合应用场景所属行业的监测系统性能测试规范;
d) 智能决策,利用多模态模型,辅助医疗、法律、金融等行业内对多模态数据的分析与决策,模型输出应附带决策依据,应明确人机协同决策的责任边界,模型输出应包含决策依据的可追溯信息(如关键证据模态、特征贡献度)与置信水平标识;对于高风险决策场景,应建立人工复核强制触发机制,具体风险等级划分见ISO/IEC 23894:2024;
e) 跨模态推荐系统,借助跨模态整合,基于用户输入的多模态数据提供更加准确的推荐;
f) 多模态场景理解,利用多模态模型,理解和分析场景、环境信息,服务于智能驾驶、机器人导航等应用;
g) 具身智能,利用多模态模型理解视觉、语言、触觉等多源信息,作为机器人执行任务的综合感知与决策核心,实现自主交互、任务规划与实时控制。
9.4 用户反馈收集
9.4.1 反馈类型
多模态大模型下游应用的用户反馈应包括但不限于以下类型:
a) 使用意见:对多模态模型输出内容的主观描述,如存在的问题,内容的合理性等;
b) 打分:按照一定标准,对多模态模型输出结果的评分;
c) 偏好:面对同一输入,对多模态模型不同输出结果的偏好性;
d) 合规性反馈:对模型输出内容的合规性、伦理问题的投诉与建议;
e) 可解释性反馈:对模型决策过程解释清晰度的评价与建议。
9.4.2 反馈渠道
应提供多种渠道(如调查问卷、反馈按钮等)收集用户反馈,允许用户通过不同的模态(文本、语音、图像、视频)提供反馈。
9.4.3 反馈储存
在保证用户反馈的数据安全的情况下,应与多模态模型的上下文相关联,支持非文本模态反馈(如语音、图像)自动转译或标注为结构化信息,并通过标准化的数据格式进行结构化存储,便于后续分析和模型改进。结构化存储采用JSON 格式,包含反馈序列号、反馈时间、反馈模态、反馈内容、反馈类型等字段。
9.4.4 反馈有效性评估
应结合自动化工具与人工审核进行反馈评估,筛选出与模型性能缺陷、功能不足、合规风险等相关的有效反馈。
9.4.5 反馈应用与持续优化
应按照7.2、7.3的要求使用用户反馈对模型进行持续优化。
9.5 安全合规检查
多模态大模型在输出内容和应用部署中应符合以下应用安全要求:
a) 隐私安全:输出结果不违反国家相关法律法规;输出结果中涉及个人信息的内容采用匿名化、去标识化处理,敏感信息脱敏率达到100%;
b) 内容安全:模型输出内容符合 GB/T 46800等相关国家标准;
c) 内容标识:对模型生成内容按照 GB 45438进行显著标识,避免与真实内容混淆,防止虚假信息传播;
d) 持续监控:部署后建立性能漂移监测机制,每月至少评估一次模型在多模态任务上的性能衰减,衰减超过5%时触发模型重训练或更新。
评论