


前言
本文件为规范类指导性技术文件
本文件按照 GB/T 1.1—2020《标准化工作导则 第1部分:标准化文件的结构和起草规则》的规定起草。
请注意本文件的某些内容可能涉及专利。本文件的发布机构不承担识别专利的责任。
本文件由全国智能计算标准化工作组(SAC/SWG 32)提出并归口。
本文件起草单位:上海曦智科技股份有限公司、之江实验室、北京航天计量测试技术研究所、上海交通大学 中移(苏州)软件技术有限公司 华中科技大学 联合微电子中心有限责任公司 杭州爱杰光电科技有限公司、光本位智能科技(上海)有限公司、中国信息通信研究院、苏州盛科通信股份有限公司、西安电子科技大学、中移(杭州)信息技术有限公司。
本文件主要起草人:于山山、华士跃、虞绍良、孟怀宇、沈亦晨、乔波、王忠新、冯宇祥、邹卫文、王山龙、董建绩、李强、周治平、姚金鑫、张乾、成伟、项水英、褚灵璐。
光电计算光矩阵计算系统设计指南
1 范围
本文件确立了光矩阵计算系统设计的总体原则和设计流程,提供了光矩阵计算系统架构设计、硬件层设计、软件层设计、应用层设计以及软硬件协同设计的指导和建议。
本文件适用于光矩阵计算系统的设计、模拟和开发。
2 规范性引用文件
下列文件中的内容通过文中的规范性引用而构成本文件必不可少的条款。其中,注日期的引用文件,仅该日期对应的版本适用于本文件;不注日期的引用文件,其最新版本(包括所有的修改单)适用于本文件。
GB/T 46572—2025 智能计算 术语
3 术语和定义
GB/T 46572—2025界定的以及下列术语和定义适用于本文件。
3.1
光矩阵计算 optical matrix computing
一种利用光作为载体进行矩阵向量计算的技术。
3.2
光矩阵计算系统 optical matrix computing system
以光矩阵计算为核心,构建硬件层、软件层及应用层协同适配的软硬件一体化计算系统
4 缩略语
下列缩略语适用于本文件。
AI:人工智能(Artificial Intelligence)
DRAM:动态随机存取存储器(Dynamic Random Access Memory)
I/O:输入/输出(Input/Output)
NoC:片上网络(Network on Chip)
OPU:光处理单元(Optical Processing Unit)
PLL:锁相环(Phase Locked Loop)
SRAM:静态随机存取存储器(Static Random Access Memory)
5 总体原则
5.1 系统完整性原则
光矩阵计算系统可作为整体进行设计,统一规范硬件层、软件层与应用层之间的接口和协同关系。
5.2 硬件无感与接口抽象原则
软件层对上层应用屏蔽底层光学硬件的物理差异,通过统一的算子库和指令集提供标准化调用接口,保障应用层的可移植性与生态兼容性。
6 系统架构设计
6.1 概述
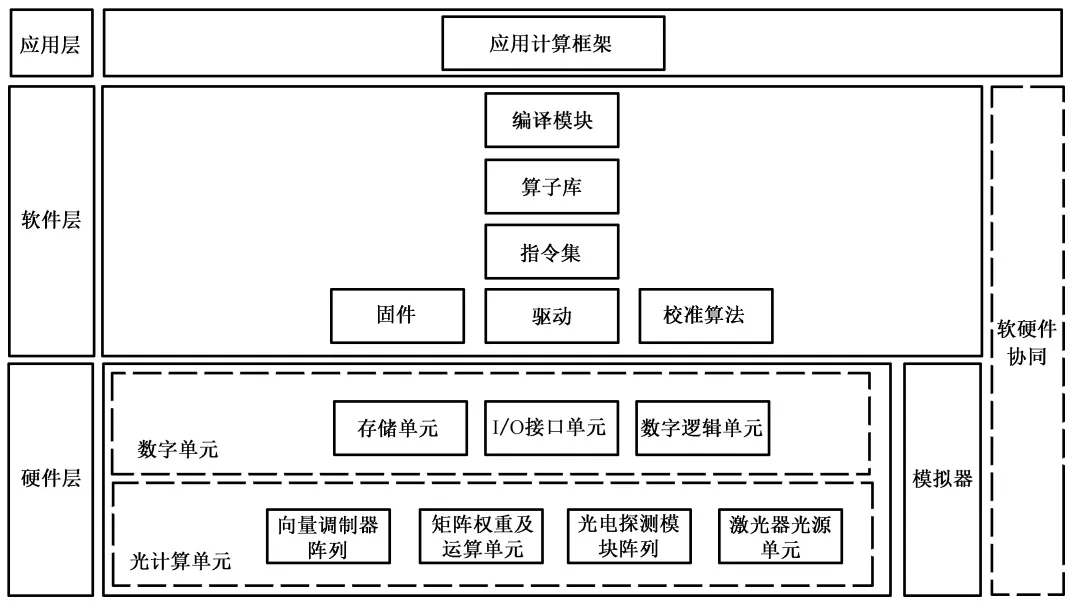
光矩阵计算系统主要提供矩阵计算加速的功能,通过软件层面抽象调用接口接入现有软件编译生态,构建用户硬件无感的完整混合范式异构加速计算解决方案。该系统架构如图1所示,主要由硬件层、软件层和应用层等组成,并能根据实际设计需求进行调整。
6.2 硬件层
硬件层包含光计算单元、数字单元和模拟器,其中光计算单元包含向量调制器阵列、矩阵权重及运算单元、光电探测模块阵列、激光器光源单元,数字单元包含I/O 接口单元、存储单元和数字逻辑单元。
6.3 软件层
软件层主要用于与硬件层配合完成各项计算任务,软件层包含固件、驱动、校准算法、指令集、算子库和编译模块。
6.4 应用层
应用层由应用计算框架构成。
7 硬件层设计
7.1 光计算单元
7.1.1 向量调制器阵列
向量调制器阵列通过对计算光信号的相位和幅度调制实现光矩阵计算中输入向量元素的加载。向量调制器阵列设计宜:
a) 包含电光调制器单元,配套的驱动单元以及数模转换单元;
b) 支持各单元的参数化配置;
c) 包含所需的光电数模I/O 接口;
d) 支持对向量调制单元的校准。
7.1.2 矩阵权重及运算单元
矩阵权重及运算单元作为矩阵计算的基本运算单元,通过光电调控单元或异质集成单元等具备光学调制功能的单元实现矩阵元素的加载。矩阵权重及运算单元设计宜:
a) 包含权重调制单元,配套的驱动单元及数模转换单元;
b) 支持各单元的参数化配置;
c) 包含所需的光电数模I/O 接口;
d) 支持对权重调制单元的校准。
7.1.3 光电探测模块阵列
光电探测模块阵列通过接收光信号并转换为光电流,实现光矩阵计算结果的提取。光电探测模块阵列设计宜:
a) 包含光电探测单元及模数转换单元;
b) 支持各单元的参数化配置;
c) 包含所需的光电模数I/O 接口。
7.1.4 激光器光源单元
激光器光源单元通过产生波长、功率、线宽等参数稳定的光源,为光矩阵计算提供计算光信号。激光器光源单元设计宜:
a) 支持功率、波长的调节;
b) 满足光计算硬件的线宽、噪声需求。
7.2 数字单元
7.2.1 存储单元
存储单元包含多种存储形式,满足不同数据类型的存储需求,用于计算数据、控制指令等数据的存储。存储单元设计宜:
a) 包含寄存器、SRAM、DRAM 等存储单元;
b) 该单元可用于计算数据的存储、控制指令的存储等。
7.2.2 I/O接口单元
I/O 接口单元是向量调制器阵列、矩阵权重及运算单元、光电探测器模块阵列中均包含的基本硬件结构,用于实现光矩阵计算硬件与外部设备的数据交互。I/O 接口单元设计宜:
a) 支持与其他计算、存储、通信等单元的数据交互;
b) 支持计算单元控制信号的可编程性。
7.2.3 数字逻辑单元
数字逻辑单元是对光矩阵计算单元计算功能的补充,实现完整的计算要求。数字逻辑单元设计宜:
a) 支持多种数据处理功能,至少支持:
1) 非线性激活运算,如 ReLu,LeakyRelu,Sigmoid等;
2) 缩放、动态量化反量化运算;
3) 累加运算;
4) 支持对 OPU 的拼接运算等;
b) 包含 PLL、NoC等单元。
7.3 模拟器
7.3.1 概述
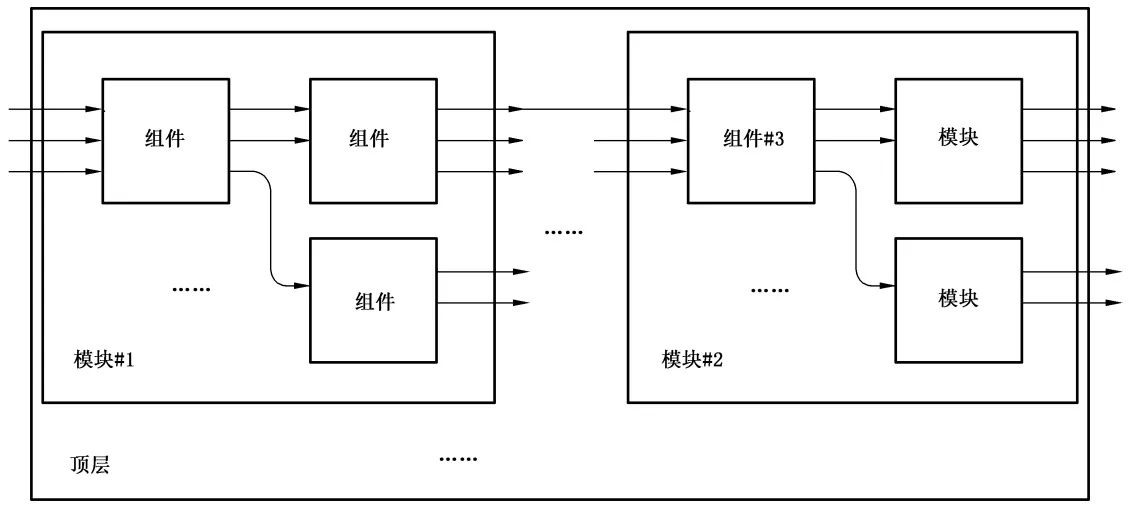
模拟器采用层次化设计模拟方式,从最基础的单元组件出发,逐层构建并模拟光矩阵计算系统的底层硬件,并结合架构中的软件层和应用层,能根据目标应用场景辅助芯片的定义和设计,实现从基础组件到应用场景的全链路性能验证。模拟器的设计包含组件、模块、顶层,这三个层级如图2所示
7.3.2 组件
组件是构建模拟器的基础单元,通过自由组合的方式可向上构建各种模块。组件设计宜:
a) 包含必要的光、电输入输出端口;
b) 支持组件的参数化配置,根据配置参数进行物理行为建模,准确反映组件的物理特性;
c) 支持组件的实例化。
7.3.3 模块
模块是指支持某种特定功能的组件、子模块的集合。模块设计宜:
a) 支持层次化设计,支持基于组件和子模块、组件和组件、子模块和子模块创建新的功能模块;
b) 包含对应层级的输入输出接口,支持组件、模块间的快速连接;
c) 至少包含基础的加法、乘法、矩阵向量乘法功能。
7.3.4 顶层
顶层是指最终用于实现光矩阵计算的物理建模,能执行矩阵与向量的乘法以及其他必要运算。顶层设计宜:
a) 支持对光矩阵计算模拟器的校准;
b) 能实现向量点乘或矩阵乘法等计算功能及其他必要的运算;
c) 支持模拟器的参数化配置;
d) 反映真实硬件的性能,包括光计算的主频、功耗和计算精度等关键指标;
e) 模拟器运行速度需满足应用场景验证需求。
8 软件层设计
8.1 校准算法
校准算法通过对模块或组件输入输出的逻辑控制,规范其执行行为,确保系统实现功能与设计功能的一致性。校准算法设计宜:
a) 能控制器件采集执行数据并建模各器件输入与输出关系;
b) 建立算法逻辑,根据器件差异迭代反馈补偿并分析校准算法对系统精度的影响;
c) 建立校准后硬件信号补偿机制,并通过软硬件手段调制信号。
8.2 固件
固件是运行在设备端的功能软件集合,用于直接控制和管理硬件执行逻辑。固件设计宜满足以下要求:
a) 运行在设备端的嵌入式软件;
b) 主要功能包括系统初始化、系统运行时库管理、系统监控、上位机服务请求响应等
8.3 驱动
驱动是运行在上位机中的软件模块,用于实现对硬件的控制和通信。驱动设计宜:
a) 实现上位机驱动光计算卡,包括硬件初始化和控制功能,系统内存与板载内存的管理功能等;
b) 需提供功能接口满足上位机调用。
8.4 指令集
指令集是系统定义的一组标准化操作命令,明确用户能调用的指令及其格式、语义和接口规范。指令集设计宜:
a) 包含光矩阵计算指令、数据存取指令及逻辑控制指令;
b) 支持其他数字单元的控制指令;
c) 包含特定算法优化指令。
8.5 算子库
算子库作为用户接口,是一系列光矩阵计算对应的功能算子的集合。算子设计宜:
a) 定义算子实现功能,输入向量的数据类型与尺寸,输入矩阵的数据类型与尺寸,输出向量的数据类型等;
b) 支持多维张量的矩阵计算及卷积计算;
c) 接口设计满足软件栈的接口要求,能通过接口函数调用芯片、传入数据并执行算子功能,最终输出结果。
8.6 编译模块
编译模块通过应用算法模型的执行与优化,可解析为计算图表达并转换为芯片指令,实现硬件执行。编译模块设计宜:
a) 能导入常见 AI模型,并解析成适合光矩阵计算系统运行的计算图表达;
b) 优化计算流程,满足模型的性能及精度要求;
c) 生成能被芯片系统执行的系列指令。
9 应用层设计
应用计算框架主要满足调用应用算法模型,并实现芯片系统后端集成。应用计算框架设计宜:
a) 兼容至少一种现有常见 AI计算框架,如 Pytorch、Tensorflow 等;
b) 支持多种 AI算法模型的端到端开发与部署;
c) 包含硬件感知优化算法以适配光矩阵计算系统;
d) 支持部署在多种硬件平台上,包含服务器或桌面计算机等;
e) 支持操作系统,包含 Windows、Linux等。
10 系统架构设计流程
10.1 概述
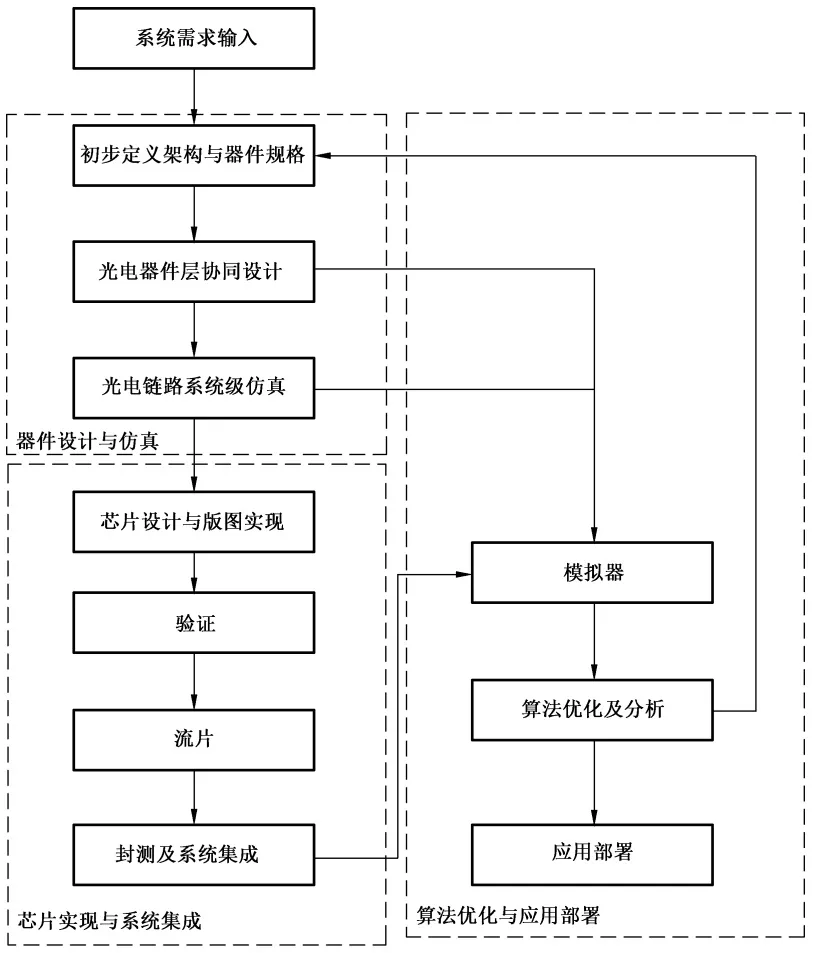
光矩阵计算系统架构设计遵循光电协同与软硬件协同原则,核心流程如图3所示,实现从器件层设计、硬件实现至算法优化及应用部署的全链路流程。
10.2 器件设计与仿真
本阶段完成光计算功能单元的设计与验证,具体内容如下:
a) 根据系统需求初步确定计算架构、性能指标及关键器件的初始参数;
b) 基于初始参数开展光电器件协同设计,完成初版设计;
c) 基于初版器件设计模型搭建链路仿真系统,验证整体性能,输出经仿真验证的核心设计方案。
10.3 芯片实现与系统集成
本阶段依次完成光芯片与电芯片的系统集成,具体内容如下:
a) 基于器件仿真结果,完成芯片的版图设计,确保芯片性能、功耗、面积等指标满足系统需求;
b) 对设计完成的芯片开展功能验证与性能评估,确保芯片在不同工艺胶合工作条件下能稳定运行;
c) 验证结果通过后提交代工厂,按照工艺规范进行流片;
d) 流片完成后,依据封装规范进行芯片封装与测试验证,完成系统集成。
10.4 算法优化与应用部署
本阶段基于实测数据校准模拟器,完成算法优化与应用部署,具体内容如下:
a) 依据器件设计阶段的仿真结果搭建模拟器,并在芯片回片后,利用实测数据对模拟器进行校准;
b) 基于模拟器环境开展算法的优化与验证分析;
c) 将经过验证的最优策略部署至真实硬件系统。
11 软硬件协同设计
11.1 设计要素
11.1.1 软硬件协同设计是指在光矩阵计算系统设计过程中,软件和硬件的开发与优化相互配合、同步进行的一种方法,通过不断地反馈循环,调整软件和硬件的设计,满足系统的最终需求。
11.1.2 软硬件协同设计宜包含以下内容。
a) 系统级设计:
1) 包含整体架构设计,确保软硬件在架构层面的统一,应用架构分层,明确每层的功能;
2) 包含接口定义,明确软硬件之间的数据交互格式和通信协议,设计对应的应用程序接口,确保模块之间的有效协作;
3) 协同设计工具宜选择能支持软硬件联合仿真的工具,在设计早期进行系统仿真验证,进行系统级优化迭代。
b) 性能优化:
1) 实现对计算、存储、I/O 资源的动态分配和管理,确保系统性能最大化;
2) 合理分配任务优先级,设计高效的任务调度策略。
11.1.3 软硬件协同设计宜:
a) 提供仿真硬件环境的模拟器,为软件进行功能验证及应用测试;
b) 提供硬件整体架构规格文档,子模块功能描述文档及测试方案;
c) 提供指令集设计文档;
d) 提供软件接口架构文档,子模块功能描述文档及测试方案;
e) 提供系统性能及功能测试方案。
11.2 模拟仿真流程
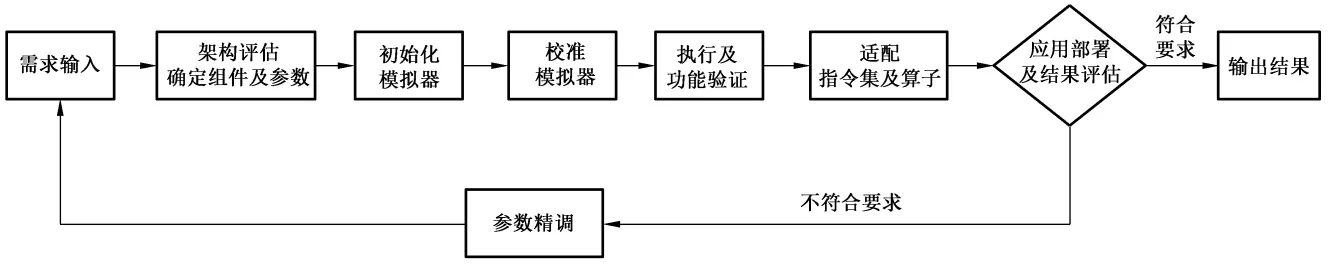
光矩阵计算系统通过模拟器进行功能模拟和仿真,在模拟仿真过程中,输入一组以二维矩阵或一维向量表达的数字信号,经过处理后以矩阵或向量形式返回相同规格的数字信号,整个过程模拟了系统中从组件的物理行为到顶层的输出。模拟仿真的主要流程如图4所示,包括
a) 根据计算需求评估系统整体架构,确定系统所需的所有组件及组件的参数,定义所需模块;
b) 初始化模拟器:基于定义参数的典型值和变化范围,随机生成个性化的组件,构建虚拟的光计算硬件;
c) 校准模拟器:修正系统中的非线性、误差等,使系统能执行线性计算;
d) 执行及功能验证:执行随机的矩阵乘法,验证其计算精度;
e) 适配指令集及算子:基于硬件执行结果生成指令集及矩阵计算算子;
f) 应用部署及结果评估:通过上层的软件接口调用相应光学矩阵计算系统的算子在应用负载下验证其功能及性能的可部署性,进行结果评估;根据评估结果反向评估架构、组件及参数,若未达到需求宜调整参数,返回重新确认所需的组件及组件的参数,完成闭环优化迭代;
g) 输出结果:包括最终选用的架构、组件及其参数、模型部署效果,以及光矩阵计算系统的性能指标(如矩阵规模、算力、计算精度、能效等)。
11.3 系统性能指标
软硬件协同设计的系统级性能指标至少包含以下内容。
a) 矩阵规模:单次矩阵向量乘法至连续的矩阵乘法,其中矩阵的宽度为输入向量的长度,矩阵的高度为输出向量的长度。
b) 有效计算精度:由于光计算为模拟计算,计算误差主要源自校准偏差和系统噪声,计算误差按公式(1)计算:
ε = Σi=0m-1 [ (xi + Deltaxi) (yi + Deltayi) - xi yi ] + n(1)
ε 计算误差;
m 点乘长度;
xi 参与运算的第一组操作数的第 i 个元素;
Deltaxi 第一组操作数第 i 个计算元素的自校准偏差;
yi 参与运算的第二组操作数的第 i 个元素;
Deltayi 第二组操作数第 i 个计算元素的自校准偏差;
n 系统噪声。
归一化的计算误差标准差按公式(2)计算:
σ = (ε)/(XFSR)(2)
σ 归一化的计算误差标准差;
XFSR 满输出量程。
有效计算精度用 log2σ 表示,通常用这一值表征系统的计算精度。
c) 算力:评估硬件计算能力的直接标准,表示硬件在单位时间内能完成的运算次数。光矩阵计算硬件中,算力与矩阵规模和系统主频有关,按公式(3)计算:
C = N/t(3)
———算力;
N 运算次数;
———时间。
d) 工作频率:系统模拟器件的统一运行主频。
e) 吞吐率:计算所需的输入输出带宽,即输入向量与输出向量的数据量和计算主频的乘积,按公式(4)计算:
R = (Nin + Nout) timesf(4)
R 吞吐率;
Nin 输入向量的数据量;
Nout 输出向量的数据量;
f 计算主频。
f) 时延:从数字端加载到数字端写入所需时间,按公式(5)计算:
τ = tload - twrite(5)
τ 时延;
tload 数字端开始加载数据的时刻;
twrite 数字端完成数据写入的时刻。
g) 能效比:单位功耗下提供的算力,按公式(6)计算:
η = C/P(6)
η 能效比;
P 系统总功耗。
h) 计算密度:单位面积提供的算力,按公式(7)计算:
ρ = C/A(7)
ρ 计算密度;
A 系统有效面积。
评论